13 октября 2026 года у нас был готовый английский рилс с аватаром, который основатель не хотел выпускать из-за голоса, аккаунт HeyGen с 2 кредитами на балансе и основатель, который не хотел его пополнять. Новое видео этого рилса в HeyGen стоило бы около 36 кредитов. Мы поменяли голос и оставили видео. Ниже — как, сколько это стоило в кредитах ElevenLabs и где ломалось.
Ситуация
Рилс сделан ИИ: цифровой двойник основателя в HeyGen (весь наш пайплайн), около 29 секунд, озвучка английским клоном его голоса в HeyGen. Голос он забраковал как роботизированный и металлический (что мы намерили) и спросил, нельзя ли исправить звук уже после: «может, звук сможешь почистить… вопрос был больше в постобработке и монтаже».
Ещё он считал, что другой движок голоса сломает липсинк. Не сломает, если сохранится тайминг. HeyGen двигает рот под тот звук, который ему дали. Speech-to-speech берёт запись и произносит её заново другим голосом с теми же словами, ритмом и паузами, поэтому губы, подходившие к старому голосу, подходят и к новому.
Как мы это сделали, по шагам
- Берём голос без потерь, на котором строилось видео, а не сжатый звук из самого видео.
- Конвертируем весь дубль одним запросом к API speech-to-speech в ElevenLabs, никогда не по фразам. Наши настройки: stability 0,5, similarity 0,8, style 0, speaker boost включён, удаление фонового шума выключено.
- Подбираем модель под голос. Библиотечные голоса шли на
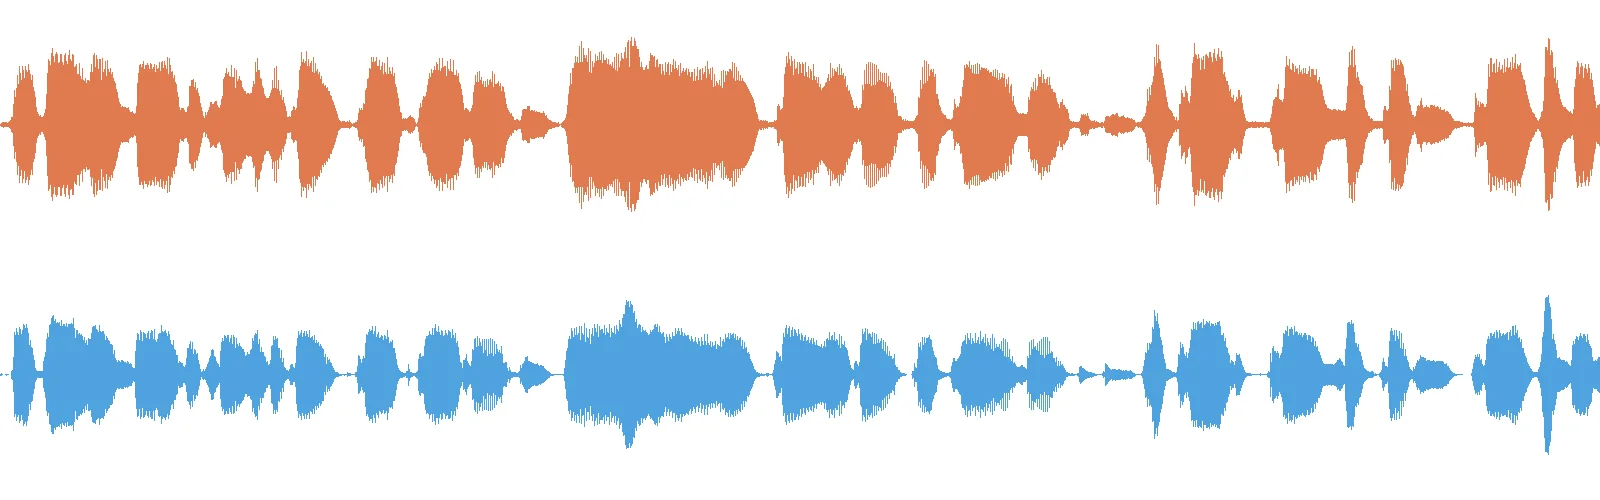
eleven_english_sts_v2, собственному клону основателя в ElevenLabs понадобиласьeleven_multilingual_sts_v2. - Выравниваем результат по исходнику. Наш скрипт сравнивает огибающие громкости двух файлов с шагом 5 мс, сдвигает конвертацию на лучшее совпадение, обрезает её до длины исходника и печатает сдвиг и корреляцию. После этого слова ложились в пределах 0,06 с от оригинала.
- Подкладываем под готовый рендер. Новый голос выравнивается по звуку рендера с точностью до 1 мс и заменяет его, обе версии — для Instagram и YouTube — пересобираются.
- Проверяем как новый дубль. Расшифровка против сценария, никакого подъёма на последней строке, никаких пауз длиннее нашего предела, никаких щелчков, −14 LUFS и совпадение формы волны между рендером и голосом. Неудачную конвертацию повторяют, а не латают.
Результаты
- Первый круг, 13 октября. Liam, Tyler и Adam плюс подогнанный по тембру клон — четыре готовые версии поверх прежнего видео. Все четыре прошли нашу проверку звука, каждое слово в пределах 0,06 с от оригинала. Mark не прошёл — посторонний звук на 5,9 с и подъём на последней строке — и выбыл.
- Второй круг, тем же вечером. Собственный клон основателя в ElevenLabs, Don, Jerry, Ryan Kurk и Aidan. Justin выбыл: последняя строка уходила вверх.
- Выбор. Из восьми готовых версий основатель выбрал свой клон в ElevenLabs. Обе версии рилса пересобрали на нём, они прошли контроль перед публикацией и встали в очередь на 15 октября: Instagram в 12:00 UTC пробным рилсом, YouTube в 12:01 UTC. Нового видео в HeyGen не понадобилось.
- Три рилса из очереди переделаны. Той же ночью три английских рилса, уже стоявших в очереди, — шесть файлов — переозвучили, проверили, отменили и создали заново на прежнее время, после слов основателя: «Да, 100% нужно отменить и выложить нормально».
- Постоянный шаг. С тех пор каждый английский дубль конвертируется до генерации видео в HeyGen, так что губы делаются уже под тот голос, который выйдет.
Что не сработало
- Повторяемость. Конвертация не повторяется. Один и тот же файл в каждом вызове даёт другой результат, и концовка, поднявшаяся в одном, в следующем падает. На шесть файлов ушло 14 конвертаций, не больше трёх на файл.
- Что ломалось по пути: подъём на последней строке, одна фраза на 3,5 дБ громче соседних, пауза 0,29 с посреди предложения.
- Голоса, которые не прошли совсем: Mark и Justin.
- Английская модель на личном клоне добавляла посторонний звук.
- Ложная тревога. «Щелчок», который нашла наша проверка, оказался взрывом звука t в слове "tried".
- Принятая находка. В одном рилсе все четыре конвертации тянули конец фразы "AI agents." 0,16–0,17 с при нашем пределе 0,15 с. Основатель эту версию слышал и одобрил, поэтому контроль записывает её как принятую находку, а не как провал.
- Подачу это не чинит. Переозвученные голоса сохранили узкий диапазон тона исходника: 2,4–3,3 полутона против примерно 6 у студийного голоса, читающего текст.
- От шипения это не лечит. 10 октября в сравнении на одном рилсе версия через speech-to-speech (тайминг в пределах 5 мс) проиграла мягкой цепочке эквалайзера на исходном голосе: основатель выбрал цепочку.
- Кредиты общие. В тот вечер в ElevenLabs оставалось 3 756 кредитов, общих с анимационными рилсами до обнуления 30 октября, поэтому конвертации считают до начала партии.
Как сделать самому
- Сохраните ровно тот звук, который загружали в сервис аватаров, и конвертируйте этот файл целиком.
- Вызывайте speech-to-speech с выключенным удалением фонового шума; если английская модель портит клонированный голос, попробуйте мультиязычную.
- Выровняйте результат по огибающей громкости исходника, обрежьте до той же длины и проверьте, что сдвиг близок к нулю.
- Подложите звук под готовое видео и посмотрите на рот на нескольких твёрдых согласных.
- Расшифруйте результат и проверьте, что последняя строка падает; если что-то не так, конвертируйте заново.
- Для другого чтения запишите новый дубль и сделайте новое видео: конвертация сохраняет старое чтение.
- Пересоберите все версии и замените посты в очереди. Мы отменяем и создаём их заново в Mellow Hub на то же время.
Цифры коротко
| Что | Цифра |
|---|---|
| Тайминг слов после конвертации | в пределах 0,06 с |
| Кредиты ElevenLabs на 29-секундный дубль | около 350 |
| На одну конвертацию в наших рилсах | 350–450 |
| Новое видео HeyGen, которое не понадобилось | около 36 кредитов |
| Конвертаций на шесть файлов | 14 |
| Готовых голосов в сравнении | 8 |